SQL Abfrage optimieren

didi577

Bekanntes Mitglied
Hallo,

ich habe hier eine mySQL Abfrage. Ich denke sie kann performanter geschrieben werden. Ich möchte erreichen das NULL Werte mit 0 in der Spalte angezeigt werden. Ich denke das macht es aber langsam.
Java:
SELECT t.user22 AS Gruppe, IFNULL(a.Anzahl, 0) AS SecLevel, FORMAT(IFNULL(a.Schnitt, 0), 0) AS Schnitt, IFNULL(b.Anzahl, 0) AS ThiLevel, FORMAT(IFNULL(b.Schnitt, 0), 0) AS Schnitt,  IFNULL(c.Anzahl, 0) AS Gesamt
FROM crmdb.tickets t
LEFT JOIN (SELECT t.user22, COUNT(t.tnumber) AS Anzahl, (SUM(DATEDIFF(curdate(), from_unixtime(t.createtime)))/ COUNT(t.tnumber)) AS Schnitt 
FROM crmdb.tickets t 
WHERE (t.status = 0 OR t.status = 1) 
AND t.tnumber LIKE 'HL-%' 
AND user26 = '' 
GROUP BY t.user22) a ON a.user22 = t.user22
RIGHT JOIN (SELECT t.user22, COUNT(t.tnumber) AS Anzahl, (SUM(DATEDIFF(curdate(), from_unixtime(t.createtime)))/ COUNT(t.tnumber)) AS Schnitt 
FROM crmdb.tickets t 
WHERE (t.status = 0 OR t.status = 1) 
AND t.tnumber LIKE 'HL-%' 
AND user26 != '' 
GROUP BY t.user22) b ON b.user22 = t.user22
RIGHT JOIN (SELECT t.user22, COUNT(t.tnumber) AS Anzahl
FROM crmdb.tickets t 
WHERE (t.status = 0 OR t.status = 1) 
AND t.tnumber LIKE 'HL-%' 
GROUP BY t.user22) c ON c.user22 = t.user22
GROUP BY t.user22
;
12416

Kann mir jemand helfen?
 

Anhänge

  • 2019-09-23_12h41_35.png
    2019-09-23_12h41_35.png
    11,2 KB · Aufrufe: 143
  • 1569235473972.png
    1569235473972.png
    16,6 KB · Aufrufe: 138
Wenn ich es richtig sehe, willst Du (Achtung: ungetestet):
SQL:
SELECT user22 AS Gruppe, 
       anzahl_leer AS SecLevel,
       FORMAT(COALESCE(summe_differenz/anzahl_leer, 0), 0) AS Schnitt, 
       anzahl_nicht_leer AS ThiLevel, 
       FORMAT(COALESCE(summe_differenz/anzahl_nicht_leer, 0), 0) AS Schnitt,
       anzahl_gesamt AS Gesamt
  FROM (SELECT user22,
             coalesce(sum(case when user26 = '' then 1 else 0),0) as anzahl_leer,
             coalesce(sum(case when user26 <> '' then 1 else 0), 0) as anzahl_nicht_leer,
             coalesce(sum(number)) as anzahl_gesamt,
             coalesce(sum(datediff(curdate(), from_unixtime(createtime))), 0) as summe_differenz
        FROM crmdb.tickets
       WHERE status in (0,1) and tnumber like 'HL-%'
       GROUP BY user22) t
 
es kommt leider noch dieser Fehler:

18:50:45 SELECT user22 AS Gruppe, anzahl_leer AS SecLevel, FORMAT(COALESCE(summe_differenz/anzahl_leer, 0), 0) AS Schnitt, anzahl_nicht_leer AS ThiLevel, FORMAT(COALESCE(summe_differenz/anzahl_nicht_leer, 0), 0) AS Schnitt, anzahl_gesamt AS Gesamt FROM (SELECT user22, coalesce(sum(case when user26 = '' then 1 else 0),0) as anzahl_leer, coalesce(sum(case when user26 <> '' then 1 else 0), 0) as anzahl_nicht_leer, coalesce(sum(number)) as anzahl_gesamt, coalesce(sum(datediff(curdate(), from_unixtime(createtime))), 0) as summe_differenz FROM crmdb.tickets WHERE status in (0,1) and tnumber like 'HL-%' GROUP BY user22) t Error Code: 1064. You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near '),0) as anzahl_leer, coalesce(sum(case when user26 <> '' then 1 els' at line 8 0.078 sec
 
Ach, ich sehe, ich habe das end vergessen und bei coalesce(sum(number)) auch das 0. Probier mal
SQL:
SELECT t.user22 AS Gruppe,
       anzahl_leer AS SecLevel,
       FORMAT(COALESCE(summe_differenz/anzahl_leer, 0), 0) AS Schnitt,
       anzahl_nicht_leer AS ThiLevel,
       FORMAT(COALESCE(summe_differenz/anzahl_nicht_leer, 0), 0) AS Schnitt,
       anzahl_gesamt AS Gesamt
  FROM (SELECT user22,
             coalesce(sum(case when user26 = '' then 1 else 0 end),0) as anzahl_leer,
             coalesce(sum(case when user26 <> '' then 1 else 0 end), 0) as anzahl_nicht_leer,
             coalesce(sum(number),0) as anzahl_gesamt,
             coalesce(sum(datediff(curdate(), from_unixtime(createtime))), 0) as summe_differenz
        FROM crmdb.tickets
       WHERE status in (0,1) and tnumber like 'HL-%'
       GROUP BY user22) t
Wenn das nicht funktioniert, kannst Du mal die CREATE-Abfrage zur Erzeugung der Tabelle hier einstellen?
 
läuft jetzt erstmal...sau schnell...vielen Dank

die Spalten Schnitt und Gesamt klemmen noch

das kommt raus:
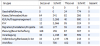
12418

das muss rauskommen:
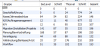
12419
 
die Spalten Schnitt und Gesamt klemmen noch
Argh, nächster Versuch - ich hoffe, ich habe keine Klammern übersehen.

SQL:
SELECT t.user22 AS Gruppe,
       anzahl_leer AS SecLevel,
       FORMAT(COALESCE(differenz_leer/anzahl_leer, 0), 0) AS Schnitt,
       anzahl_nicht_leer AS ThiLevel,
       FORMAT(COALESCE(differenz_nicht_leer/anzahl_nicht_leer, 0), 0) AS Schnitt,
       anzahl_gesamt AS Gesamt
  FROM (SELECT user22,
             coalesce(sum(case when user26 = '' then 1 else 0 end),0) as anzahl_leer,
             coalesce(sum(case when user26 <> '' then 1 else 0 end), 0) as anzahl_nicht_leer,
             count(number) as anzahl_gesamt,
             coalesce(sum(case when user26 = ''
                 then datediff(curdate(), from_unixtime(createtime))
                 else 0
               end), 0) as differenz_leer,
             coalesce(sum(case when user26 <> ''
                 then datediff(curdate(), from_unixtime(createtime))
                 else 0
               end), 0) as differenz_nicht_leer
        FROM crmdb.tickets
       WHERE status in (0,1) and tnumber like 'HL-%'
       GROUP BY user22) t
 
Nein. COALESCE entspricht dem SQL-Standard. Es kann mehrere Argumente entgegennehmen und liefert das erste, das nicht NULL ist. IFNULL() ist dagegen eine mySQL-spezifische Funktion, die das zweite Argument liefert, wenn das erste NULL ist. Im konkreten Fall machen also beide das gleiche.

Die höhere Geschwindigkeit kommt daher, dass nur einmal durch die Tabelle gegangen werden muss, nur einmal gruppiert wird und keine JOINs, insbesondere keine OUTER JOINs verwendet werden.

Wenn Du den genauen Unterschied sehen willst, kannst Du Dir anschauen, was die DB macht, indem Du Dir den Ausführungsplan anzeigen lässt. Das MySQL Workbench kann Dir das grafisch anzeigen. Auf Textbasis funktioniert das, wenn Du die Abfragen ausführst und einfach EXPLAIN davor schreibst (also EXPLAIN SELECT ...) Die Interpretation ist aber nicht ganz einfach: https://dev.mysql.com/doc/refman/8.0/en/explain-output.html
 
Hi. Ich habe hier noch so eine Abfrage wo man sicher noch Performance rausholen kann. Im Unterschied zu der oberen Abfrage geht diese über mehrere Tabellen:

SQL:
SELECT DISTINCT t.id, 
             t.tnumber, 
             c.company, 
             t.user29, 
             t.status, 
             IF (d.Zeit IS NULL, f.Zeit, d.Zeit) AS Zeit,
             IFNULL(d.Aktionen, 0) + IFNULL(f.Anrufe, 0) AS Aktionen, 
             IFNULL(z.Aktionen, 0) + IFNULL(f.Anrufe, 0) AS AktGesamt
FROM crmdb.tickets t JOIN crmdb.contacts c ON t.cid = c.id  
        LEFT JOIN (SELECT COUNT(a.id) AS Aktionen, 
                                       a.ticket_id, 
                                       from_unixtime(a.chgtime, '%H:%i') AS Zeit 
                          FROM crmdb.tickets t JOIN crmdb.ticket_actions a ON t.id = a.ticket_id 
                          WHERE a.createuser =59
                          AND from_unixtime(a.action_date, '%Y-%m-%d') = '2019-10-01' 
                          GROUP BY t.tnumber) d ON t.id = d.ticket_id 
        LEFT JOIN (SELECT COUNT(l.ttid) AS Anrufe, 
                                       l.ttid, 
                                       from_unixtime(l.chgtime, '%H:%i') AS Zeit 
                          FROM crmdb.tickets t JOIN crmdb.calls l ON t.id = l.ttid 
                          WHERE l.createuser =59 
                          AND from_unixtime(l.createtime, '%Y-%m-%d') = '2019-10-01' 
                         GROUP BY t.tnumber) f ON t.id = f.ttid 
        LEFT JOIN (SELECT COUNT(a.id) AS Aktionen, 
                                       a.ticket_id 
                          FROM crmdb.tickets t JOIN crmdb.ticket_actions a ON t.id = a.ticket_id 
                          GROUP BY t.tnumber) z ON t.id = z.ticket_id  
WHERE t.id IN (SELECT DISTINCT a.ticket_id  
                         FROM crmdb.ticket_actions a  
                         WHERE a.ticket_id = t.id AND a.createuser =59 
                         AND from_unixtime(a.action_date, '%Y-%m-%d') = '2019-10-01')  
                         OR t.id IN (SELECT DISTINCT l.ttid 
                         FROM crmdb.calls l 
                         WHERE l.ttid = t.id 
                         AND l.createuser =59 
                         AND from_unixtime(l.createtime, '%Y-%m-%d') = '2019-10-01') 
GROUP BY t.tnumber

Die Abfrage funktioniert, nur eben langsam... kann mir jemand helfen ?
 
ich frage erstmal anders

wie baue ich eine Abfrage performant über 3 mehrere Tabellen auf ohne mit LEFT JOINS zu arbeiten ?? Dann kann ich das hier erstmal entwirren...
 
wie baue ich eine Abfrage performant über 3 mehrere Tabellen auf ohne mit LEFT JOINS zu arbeiten ?? Dann kann ich das hier erstmal entwirren...
Wäre es nicht sinnvoller, das zuerst zu entwirren und dann zu sehen, welche Probleme übrig bleiben?

Man kann noch nicht allzu viel dazu sagen, so lange du die Fragen von @mihe7 nicht beantwortest. Ein Punkt fällt mir allerdings in den Sub-SELECTs der äußeren WHERE-Bedingung auf. Warum fragst du in deren WHERE-Bedingungen noch t.id ab? Das erscheint mir überflüssig und für die Performance ist es bestimmt nicht gut, Werte von äußeren Abfragen in WHERE-Bedingungen von Sub-SELECTs hinein zu tragen, die ihrerseits Bestandteil der äußeren WHERE-Bedingung sind. Vielleicht wird es hier weg optimiert, falls es wirklich überflüssig sein sollte. Ich würde es aber lieber gleich vermeiden.
 
Die Datenbankstruktur ist vorgegeben. Darauf habe ich keinen Einfluss.

Was ist mein Ziel? Ich möchte eine Auswertung darüber wieviele Aktionen/ Anrufe ein Mitarbeiter an einem Tag je Ticket anlegt (Auswertung einer Hotline).

Zu einem Ticket (Tabelle tickets) gibt es Aktionen (Tabelle ticket_actions) und Anrufe (Tabelle calls).

Beim Anlegen einer Aktion oder eines Anrufs wird die eindeutige ID des Tickets (id) als ticket_id in ticket_actions und ttid in calls gespeichert.

Die auszugebenen Spalten sind:

tnumber - kommt aus Tabelle tickets und ist das Label des Tickets
company - kommt aus Tabelle contacts und ist als Nummer in Tabelle tickets hinterlegt
user29 - kommt 1:1 aus Tabelle tickets
status - kommt 1:1 aus Tabelle tickets
Zeit - ist der Zeitstempel wann die Aktion oder der Anruf angelegt wurde und kommt aus Tabelle ticket_actions oder calls
Aktionen - ist die Anzahl der Aktionen die der Mitarbeiter (createuser) am Tag zu einem Ticket angelegt hat
AktGesamt ist die Geamtzahl aller Aktionen und Anrufe zu einem Ticket

createuser und createtime gibt es in den Tabellen ticket_actions und calls

Da jede Aktion/ Anruf des createusers aufgeführt werden soll kann die Spalte Aktionen wegfallen da sie ja immer 1 wäre

Ich hoffe ich konnte meinen Plan erläutern.
 
Ich hoffe ich konnte meinen Plan erläutern.
Nicht ganz. Die Antwort auf diese Frage von @mihe7:
Eine andere Frage: kann ein Wert in t.number mehrfach vorkommen (gibt es in tickets wenigstens zwei Sätze s1 und s2 mit s1.id<>s2.id und s1.number = s2.number)?
wäre schon sehr interessant.

Was ist mein Ziel? Ich möchte eine Auswertung darüber wieviele Aktionen/ Anrufe ein Mitarbeiter an einem Tag je Ticket anlegt (Auswertung einer Hotline).
Das heißt, wenn beispielsweise zwei verschiedene Tickets mit dem identischen Label "Drucker geht nicht" angelegt werden, sollen die Werte der beiden nicht zusammengefasst werden (wie es deine Abfrage aus #10 tun würde), sondern pro Ticket dargestellt werden?
Falls sie doch zusammengefasst werden sollen: welches der beiden Tickets soll dann für Company und Status maßgeblich sein?
 
Nicht ganz. Die Antwort auf diese Frage von @mihe7:
ein Wert also eine id kann nur einmal in tnumber vorkommen

Das heißt, wenn beispielsweise zwei verschiedene Tickets mit dem identischen Label "Drucker geht nicht" angelegt werden, sollen die Werte der beiden nicht zusammengefasst werden (wie es deine Abfrage aus #10 tun würde), sondern pro Ticket dargestellt werden?
Falls sie doch zusammengefasst werden sollen: welches der beiden Tickets soll dann für Company und Status maßgeblich sein?
nein sie sollen nicht zusammengefasst werden

wenn ich unter einer tnumber 3 Aktionen und 2 Anrufe habe sollen mit der tnumber 5 Zeilen mit jeweils der company und dem Status dargestellt werden
 
Also, wenn ich Dich richtig verstehe, willst Du jede Aktion und jeden Anruf einzeln darstellen. Das wäre dann einfach etwa wie:
SQL:
SELECT t.tnumber,
       o.company,
       t.user29,
       t.status,
       from_unixtime(a.chgtime, '%H:%i') AS Zeit,
       'A' -- Action 
  FROM tickets t INNER JOIN ticket_actions a ON t.id = a.ticket_id
 WHERE a.createuser = 59
   AND a.createtime >= unix_timestamp('2019-10-01')
   AND a.createtime < unix_timestamp('2019-10-02')
UNION
SELECT t.tnumber,
       o.company,
       t.user29,
       t.status,
       from_unixtime(c.chgtime, '%H:%i') AS Zeit,
       'C' -- Call
  FROM tickets t INNER JOIN calls c ON t.id = c.ttid
 WHERE c.createuser = 59
   AND c.createtime >= unix_timestamp('2019-10-01')
   AND c.createtime < unix_timestamp('2019-10-02')
 
ja so wollte ich es haben, Danke

wenn ich jetzt o.company noch mit ermitteln will habe ich so angepasst:
SQL:
SELECT t.tnumber,
       o.company,
       t.user29,
       t.status,
       from_unixtime(a.chgtime, '%H:%i') AS Zeit,
       'A' -- Action 
  FROM crmdb.tickets t INNER JOIN crmdb.ticket_actions a ON t.id = a.ticket_id INNER JOIN crmdb.contacts o ON t.cid = o.id
 WHERE a.createuser = 59
   AND a.createtime >= unix_timestamp('2019-10-01')
   AND a.createtime < unix_timestamp('2019-10-02')
UNION ALL
SELECT t.tnumber,
       o.company,
       t.user29,
       t.status,
       from_unixtime(c.chgtime, '%H:%i') AS Zeit,
       'C' -- Call
  FROM crmdb.tickets t INNER JOIN crmdb.calls c ON t.id = c.ttid INNER JOIN crmdb.contacts o ON t.cid = o.id
 WHERE c.createuser = 59
   AND c.createtime >= unix_timestamp('2019-10-01')
   AND c.createtime < unix_timestamp('2019-10-02')

es funktioniert, ist aber wieder um ein vielfaches langsamer geworden, ist das normal?

in der WHERE Bedingung nutzt du unix_timestamüp statt from_unixtime...bringt das Vprteile??
 
wenn ich jetzt o.company noch mit ermitteln will
Oops, die habe ich ganz vergessen 🙂

ist aber wieder um ein vielfaches langsamer geworden, ist das normal?
Was heißt "um ein Vielfaches langsamer"? Der zusätzliche JOIN mach natürlich einen Unterschied, der sollte sich aber in Grenzen halten.

in der WHERE Bedingung nutzt du unix_timestamüp statt from_unixtime...bringt das Vprteile??
Sollte. Erstens muss so nur zweimal ein fixes Datum in den Zeitstempel umgewandelt werden, zweitens kann so der Index verwendet werden, den Du ggf. auf createtime hast. Probiers einfach aus bzw. lass Dir den Ausführungsplan anzeigen.

Führ mal die beiden Abfragen aus:
SQL:
EXPLAIN SELECT chgtime FROM ticket_actions WHERE createuser = 59 AND createtime >= unix_timestamp('2019-10-01') AND createtime < unix_timestamp('2019-10-02');

EXPLAIN SELECT chgtime FROM ticket_actions WHERE createuser = 59 AND from_unixtime(createtime, '%Y-%m-%d') = '2019-10-01' ;
Sofern Du einen Unterschied erkennst, kannst Du das Ergebnis ja mal posten.

...als letzte Spalte wollte ich auch noch die Gesamtzahl aller Aktionen und Anrufe zu dieser tnumber dargestellt haben
D. h. es gibt zu einer Ticket-Number mehrere Ticket-IDs?
 
D. h. es gibt zu einer Ticket-Number mehrere Ticket-IDs?
jede Ticketnummer hat eine t.id aber es kann zu einer t.id mehrere a.ticket_id und/oder mehrere c.ttid geben, da es zu einem Ticket mehrere Aktionen und/oder Anrufe geben kann

Was heißt "um ein Vielfaches langsamer"? Der zusätzliche JOIN mach natürlich einen Unterschied, der sollte sich aber in Grenzen halten.
ohne den zusätzlichen JOIN ca. 0,05 sec mit dem JOIN ca. 2,3 sec, wobei ich nicht weiß wie sich schnell und langsam definieren

Sofern Du einen Unterschied erkennst, kannst Du das Ergebnis ja mal posten.
es ist kein Unterschied im Ergebnis nur in der Syntax
 
ede Ticketnummer hat eine t.id aber es kann zu einer t.id mehrere a.ticket_id und/oder mehrere c.ttid geben, da es zu einem Ticket mehrere Aktionen und/oder Anrufe geben kann
Mach einfach jeweils ein zusätzliche Spalte count(*) as Anzahl dran.

Unsinn. Machen wir später.


ohne den zusätzlichen JOIN ca. 0,05 sec mit dem JOIN ca. 2,3 sec, wobei ich nicht weiß wie sich schnell und langsam definieren
Kommt mir viel zu hoch vor. Kannst Du mal ein EXPLAIN davor schreiben und das Ergebnis posten?
 
Vermutung: Du hast keine Indizes auf createuser und createtime. D. h. um z. B. aus ticket_actions die betreffenden Sätze zu ermitteln, müsste die gesamte Tabelle durchlaufen werden. Da in der Tabelle vermutlich mehr Sätze stehen als in tickets wird das geringere Übel gewählt und durch über alle Tickets iteriert.

Kannst/Darfst Du Indizes für createuser und ggf. createtime anlegen und den Spaß wiederholen?
 
hier muss wahrscheinlich noch eine Unterabfrage über ticket_actions und calls mit Gruppierung nach tnumber laufen ?
Wenn Du diese unabhängig von createuser/createtime haben willst, ja. Da muss die DB dann sowieso durch alle Actions und alle Calls laufen, so dass ein Index auf createuser/createtime eh nichts mehr nutzen würde. Mit etwas Glück dreht sich Dein Ausführungsplan nur.
 
Ne an der DB darf ich gar nichts machen. ich habe lediglich lesenden Zugriff auf ein paar Tabellen
Allerdings zeigt die Abfrage von @mihe7 aus #21, dass man performant an die beteiligten Ticket-Ids kommen kann und für die gibt es ja wohl Indizes in den Tabellen für Aktionen und Anrufe (oder ist das nicht reproduzierbar schnell, sondern vielleicht nur Folge von Caching-Effekten aus vorhergehenden Abfragen?). Vielleicht funktioniert es, die Ticket-Ids mit einer inneren Abfrage auszuwählen und die Ergebnismenge dann in einer äußeren Abfrage per Join über die Ticket-ID mit den fehlenden Daten anzureichern.

Eventuell war auch die Idee deiner ursprünglichen Abfrage aus #10 gar nicht so schlecht. Wie läuft die denn, wenn du sie mit den Erkenntnissen aus diesem Thread vereinfachst? Du könntest z.B. die Abfrage der Ticket-ID aus den WHERE-Bedingungen der beiden Sub-Selects der äußeren WHERE-Bedingung entfernen und die Sub-Selects innerhalb der LEFT JOINs könnten auch direkt (ohne JOIN) auf die jeweilige Tabelle zugreifen, wenn du dort nicht nach tnumber, sondern nach der Ticket-ID gruppierst.
 
dass man performant an die beteiligten Ticket-Ids kommen kann und für die gibt es ja wohl Indizes in den Tabellen für Aktionen und Anrufe (oder ist das nicht reproduzierbar schnell, sondern vielleicht nur Folge von Caching-Effekten aus vorhergehenden Abfragen?).
Warum der zusätzliche JOIN so viel länger brauchen soll, ist mir auch nicht klar.

Wenn ich mir #25 und seine Antwort aus #29 ansehe, würde ich mal schlussfolgern, dass es keinen Index auf createuser gibt. Für ein FROM ticket_actions a WHERE a.createuser=59 muss die DB somit alle Aktionen durchlaufen.

Im Fall des JOINs mit tickets kann man mal davon ausgehen, dass es mehr Aktionen als Tickets gibt. Damit wäre es prinzipiell nachvollziehbar, dass die DB erst über die Tickets läuft und dann die Aktionen dazu nimmt.

Andersrum wäre in dem Fall aber besser, da sowieso sämtliche Aktionen durchlaufen werden müssen und damit nicht jedes Ticket und jede Firma dazugenommen werden muss, sondern nur die, für die die WHERE-Klausel stimmt.

wenn du dort nicht nach tnumber, sondern nach der Ticket-ID gruppierst.
Das hört sich seeehr vernünftig an 🙂

Ich muss sagen, dass es deutlich einfacher ist, Abfragen zu optimieren, wenn man vor der DB sitzt... 🙂 Da probiert man das ein oder andere aus und sieht sofort, was rauskommt.
 

Neue Themen


Zurück
Oben