Java - Compilerbau

Benutzer267

Mitglied
Hey!
ich soll in meiner Schule einen "Interpretierer" schreiben.
Die Sprache heißt VgaA und ist wie folgt definiert:
VgaA: --> [ZAHL]
oder: --> ( --> VgaA --> Operator --> VgaA --> )
Operatoren sind logischerweise: +, -, *, /

Die lexikalische Analyse habe ich bereits geschrieben aber nun hänge ich an der syntaktischen und habe überhaupt keine Ideen mehr...
Vielleicht kann mir einer helfen 🙂

Hier nochmal die ganze Aufgabe:
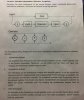
IMG_4694.jpg
IMG_4695.jpg


EDIT: Ich schreibe gleich noch meine Lexikalische Analyse hier rein. Dauert aber noch kurz. 😉
 
Hm, leider wurden damals wahrscheinlich nur die Bilder der Aufgabe in den Post gepackt; finde auf Anhieb auch nichts.

Gut, dann zum Thema:
Wo hängst du bei der Syntaktischen analyse? Garkeine Idee, wo du Anfangen sollst?
Zeig uns mal einen Test-Code (bpsw. 1 * (34 + 8) * 192) und welche Tokens dein Lexer dafür ausspuckt.
 
Main:
Java:
package aufgabe5;

public class Start {

    public static void main(String[] args) throws Exception {
        LexikalischeAnalyse lexer = new LexikalischeAnalyse();
    }
}

LexikalischeAnalyse:
Java:
package aufgabe5;
import java.io.FileReader;

public class LexikalischeAnalyse {
    /** Kein Input */
    public boolean noInput;
    /** File Reader */
    private FileReader fr;
    /** char */
    private char ch;
  
    /**
     * Methode liest aus Datei
     * @throws IOException
     */
  
    public LexikalischeAnalyse() throws Exception {
        fr = new FileReader("src/eingabe.txt");
        noInput = false;
        ch = naechsterToken();
        int i = 0;
        while (i < 20) {
            i++;
            Token t = welcherToken();
            if (t != null) {
                System.out.println("Token:" + t);
            }
        }
    }
  
    public final char naechsterToken() {
        ch = ' ';
        try {
            int i = fr.read();
            ch = (char)i;
          
            if (i < 0) {
                noInput = true;
                ch = ' ';
            }
        }
        catch (Exception e) {
            e.printStackTrace();
            noInput = true;
        }
        return ch;
    }
  
    public final Token welcherToken() {
        Token t = null;
      
        while (!noInput && Character.isWhitespace(ch)) {
            ch = naechsterToken();
        }
        if (!noInput) {
            if (Character.isDigit(ch)) {
                String s = "";
                while (Character.isDigit(ch)) {
                    s = s + ch;
                    ch = naechsterToken();
                }
                t = new Zahl(s);
            }
            else {
                switch (ch) {
                    case '+': t = new Plus();
                break;
                    case '-': t = new Minus();
                break;
                    case '*': t = new Mal();
                break;
                    case '/': t = new Geteilt();
                break;
                    case '(': t = new KlammerAuf();
                break;
                    case ')': t = new KlammerZu();
                break;
            default:
                    System.out.println("Fehler! [ungültiges Zeichen]");
                }
                ch = naechsterToken();
            }
        }
    }
}
 
Zuletzt bearbeitet:
Hm, leider wurden damals wahrscheinlich nur die Bilder der Aufgabe in den Post gepackt; finde auf Anhieb auch nichts.

Gut, dann zum Thema:
Wo hängst du bei der Syntaktischen analyse? Garkeine Idee, wo du Anfangen sollst?
Zeig uns mal einen Test-Code (bpsw. 1 * (34 + 8) * 192) und welche Tokens dein Lexer dafür ausspuckt.
Ich habe leider überhaupt keine Ideen mehr.
 
Okey, der Code sieht so aus, als ob er das tut, was du möchtest. Der nächste Schritt ist jetzt, dass du die Tokens nicht einfach nur auf der Kommandozeile Ausgiebst sonder sie in eine Liste packst, damit du sie weiter verarbeiten kannst.

Verstehst du die Diagramme, die zur Aufgabe gehören? (Also VgaA und Operator)
 
Verstehe ich nicht... Ja, man braucht Listen nicht unbedingt dazu. Aber ohne ist es ziemlich hässlich. Na egal, dann eben ohne.

Dein Code sollte nachher nach diesem Prinzip arbeiten (lege eine neue Methode interpretiere() dafür an):

- ließ das nächste Token mit welcherToken()
- entscheide was zu tun ist
- berechne das, was entschieden wurde
- gib das Ergebnis zurück

Stößt dein Code auf eine Zahl, ist das Ergebnis einfach: nämlich die Zahl. Stößt dein Code auf eine Klammer auf, passiert der Trick (mit Rekursion):
- Du liest den ersten VgaA ein, indem du interpretiere() rekursiv aufrufst. Das Ergebnis speichern.
- Du liest den Operator ein, auch den speichern
- Du liest den zweiten VgaA ein, siehe oben
- Du verrechnest die beiden Ergebnisse mit dem Operator
- das Ergebnis steht fest und du kannst es aus interpretiere() zurückgeben


Wie soll der Code sich denn bzgl. Ganzzahldivison bzw. Fließkommazahlen verhalten?
 
Vielen dank!
Fließkommazahlen sollen nicht gelesen werden. 🙂

Könntest du vielleicht doch nochmal wenn du Lust hast den Weg mit den Listen erklären? 😛
 
Fließkommazahlen sollen nicht gelesen werden. 🙂
Und berechnet? Welches Ergebnis soll der Code (3 / 4) haben? 0 oder 0.75?

EDIT: Also es wird nur die erste Zahl gelesen.
Meinst du jetzt die erste Ziffer oder die erste Zahl?

Bzgl. der Listen: es wäre sauberer, zuerst die Tokens aus der Eingabe eine List<Token> zu packen. Aus dieser Liste baut mann dann einen Abstract Syntax Tree. Den wiederum kann man dann in einer Klasse Interpreter verarbeiten. Dadurch hat man die drei Aufgaben klar voneinander getrennt: einlesen des Strings in seine Bestandteile, Definition der Syntax (Liste von Token zu AST) und Regeln der Interpretierung.
 
Ich habe jetzt schon länger etwas mehr gemacht, bin denke ich auch fast fertig aber das Programm liest nicht mehr nach einem Buchstaben weiter... Kann mir vielleicht jemand den Code verbessern?

Danke

Code:
package aufgabe5.haupt;

import aufgabe5.parser.Syntax;

public class Start {

    public static void main (String[] args) throws Exception {
        LexikalischeAnalyse lexer = new LexikalischeAnalyse();
        new Syntax(lexer);
    }
}
Code:
package aufgabe5.haupt;

import java.io.FileReader;
import java.io.IOException;

import aufgabe5.token.*;

public class LexikalischeAnalyse {

    private boolean noInput;
    private FileReader fr;
    private char ch;
    private boolean falscherToken = false;
 
    /**
    * Methode liest aus Datei.
    * @throwsIOException Exception
    */
    public LexikalischeAnalyse() throws Exception {
        fr = new FileReader("src/eingabe.txt");
        noInput = false;
        ch = naechsterToken();
    }
 
    /**
    * Methode geht zum nächsten Token.
    * [USER=49078]@Return[/USER]
    */
    public final char naechsterToken() {
        ch = ' ';
        try {
            int i = fr.read();
            ch = (char) i;
         
            if (i < 0) {
                noInput = true;
                ch = ' ';
            }
        }
        catch (Exception e) {
            e.printStackTrace();
            noInput = true;
        }
        return ch;
    }

/**
 * Methode schaut welcher Token vorhanden ist,
 * checkt ob es noch einen Input gibt
 * und löscht Whitespaee.
 */
    public final Token welcherToken() {
        Token t = null;
 
        while (!noInput && Character.isWhitespace(ch)) {
            ch = naechsterToken();
        }
        if (!noInput) {
            if (Character.isDigit(ch)) {
                String s = "";
                while (Character.isDigit(ch)) {
                    s = s + ch;
                    ch = naechsterToken();
                }
                t = new Zahl(s);
            }
            else {
                switch (ch) {
                case '+': t = new Plus();
                    break;
                case '-': t = new Minus();
                    break;
                case '*': t = new Mal();
                    break;
                case '/': t = new Geteilt();
                    break;
                case '(': t = new KlammerAuf();
                    break;
                case ')': t = new KlammerZu();
                    break;
                default:
                    falscherToken = true;
                    System.out.println("Fehlerhafte Eingabe!" + "Token: " + ch);
                }
                ch = naechsterToken();
            }
        }
        return t;
    }

    public boolean isFalscherToken() {
        return falscherToken;
    }

    public void setFalscherToken(boolean falscherToken) {
        this.falscherToken = falscherToken;
    }
 
    /**
    * GetReady.
    */
    public boolean getReady() throws IOException {
        return fr.ready();
    }
}

Code:
package aufgabe5.parser;

import aufgabe5.haupt.LexikalischeAnalyse;
import aufgabe5.token.Geteilt;
import aufgabe5.token.KlammerAuf;
import aufgabe5.token.KlammerZu;
import aufgabe5.token.Mal;
import aufgabe5.token.Minus;
import aufgabe5.token.Operator;
import aufgabe5.token.Plus;
import aufgabe5.token.Token;
import aufgabe5.token.Zahl;

public class Syntax {

    private Token to;
    private boolean f;
 
    public Syntax(LexikalischeAnalyse lexAn) throws Exception {
        to = lexAn.welcherToken();
     
        while (to != null) {
            System.out.print("VgaA: ");
            Baum b = null;
            b = vgaa(lexAn);
         
            if (b != null) {
                b.ausgeben();
            }
            System.out.println();
        }
    }
 
    public final Baum vgaa(LexikalischeAnalyse lexAn) {
     
        if (lexAn.isFalscherToken()) {
        }
     
        Baum b = null;
        Baum rechts = null;
        Baum links = null;
     
        if (to instanceof Zahl) {
            b = new KnotenZahl(to);
            to = lexAn.welcherToken();
        }
        else if (to instanceof KlammerAuf) {
            to = lexAn.welcherToken();
            links = vgaa(lexAn);
         
            if (to instanceof Operator) {
                b =  welcherOperator(lexAn);
                rechts = vgaa(lexAn);
             
                if (to instanceof KlammerZu) {
                    to = lexAn.welcherToken();
                    b.setRechts(rechts);
                    b.setLinks(links);
                }
                else {
                    fehlerMeldung(lexAn);
                }
            }
            else {
                fehlerMeldung(lexAn);
            }
        }
        else {
            fehlerMeldung(lexAn);
        }
        return b;
    }
 
    public final Baum welcherOperator(LexikalischeAnalyse lexAn) {
        Baum operator = null;
     
        if (to instanceof Plus) {
            operator = new KnotenPlus();
        }
        else if (to instanceof Minus) {
            operator = new KnotenMinus();
        }
        else if (to instanceof Mal) {
            operator = new KnotenMal();
        }
        else if (to instanceof Geteilt) {
            operator = new KnotenGeteilt();
        }
        to = lexAn.welcherToken();
        return operator;
    }
 
    public final void fm(LexikalischeAnalyse lexAn) {
        f = true;
        Baum b = vgaa(lexAn);
        to = lexAn.welcherToken();
    }
 
    public void fehlerMeldung(LexikalischeAnalyse lexAn) {
        if (!f) {
            System.out.println("Fehlerhafte Eingabe! ");
            to = lexAn.welcherToken();
         
            if (to !=null) {
                fm(lexAn);
            }
            else {
                System.exit(0);
            }
        }
    } 
}
 
Dann passieren ja offensichtlich zwei fehlerhafte Dinge: es wird nicht weiter eingelesen und die Fehlermeldung kommt vor der eigentlichen Ausgabe.

Überleg doch mal, welche Stelle da durchlaufen wird und den Fehler auslösen könnte 😉
 
Dann passieren ja offensichtlich zwei fehlerhafte Dinge: es wird nicht weiter eingelesen und die Fehlermeldung kommt vor der eigentlichen Ausgabe.

Überleg doch mal, welche Stelle da durchlaufen wird und den Fehler auslösen könnte 😉

Wie gesagt, ich denke, dass wenn ein Buchstabe vorhanden ist, to (Token) null ist und die Schleife nicht mehr weiterläuft.
 
Ich würde gerne die falschen Eingaben anders verarbeiten...Hatte es auch schon versucht, hat aber nicht funktioniert.
Kannst du es bittö für mich schreiben :,(
 

Zurück
Oben