
HTTP Allgemeine Fragen über Suchmaschine nutzen mit Java

BodyLAB

Bekanntes Mitglied
Guten Tag zusammen,

ich hab ein paar Fragen die mich gerade beschäftigen.

Was ich sehr gerne machen möchte ist nach einem Wort über ein Java Programm suchen per google zum Beispiel.
Hierzu habe ich das hier gefunden:

Hört sich gar nicht so schlecht an. Würde das auch mit java.net.URL und java.net.URLConnection Funktionieren?
Sobald ich erfolgreich suchen kann würde ich sehr gerne ein paar Strings die Gefunden wurden speichern und zwar am liebsten so etwas:
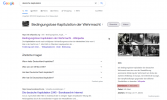
Unbenannt.png
Hier Rot eingerahmt! Also ich möchte dann wenn dort ein Startdatum und Enddatum steht diese Speichern.
Ist so etwas möglich und hat man überhaupt zugriff auf diese (ich weiß nicht wie so eine Ansicht heißt) Google Kurzinfo-Ansicht?

Dann hätte ich noch eine Frage gibt es eine Möglichkeit Hyperlinks zu erkennen?
Wieso? -> Weil man damit wenn es keine Google Kurzinfo-Ansicht existiert auf den ersten Link (oft ja Wikipedia bei mir zumindest hehe) gehen und dort dann die Webseite absuchen kann.
Gibt es vielleicht eine Möglichkeit sich dann alle Hyperlinks anzeigen zu lassen?

Bitte habt Verständnis ich hab davon NULL Plan 😟
 
Würde das auch mit java.net.URL und java.net.URLConnection Funktionieren?
Ja, REST APIs laufen über HTTP. Tatsächlich gibts von Google auch eine Java Library, die das bereits übernimmt.

(ich weiß nicht wie so eine Ansicht heißt)
Das Knowledge Panel.

Ist so etwas möglich und hat man überhaupt zugriff auf diese
Das habe ich nicht auf Anhieb in Erfahrung bringen können. Vermutlich schon.

Die Frage wäre auch, ob es um Wikipedia-Einträge geht. Die gibts auch strukturiert und man kann derlei Daten gezielt abgreifen.

Nachtrag:

Dann hätte ich noch eine Frage gibt es eine Möglichkeit Hyperlinks zu erkennen?
Natürlich. In HTML sind Links einfach a-Tags. Klick mal in Firefox oder Chrome mit der rechten Mauste auf einen Link und rufe "Untersuchen" oder "Inspect" im Menü auf, dann siehst Du, wie das im Quelltext aussieht. Und den kannst Du natürlich auslesen. Auch hierfür gibts schöne Möglichkeiten wie z. B. JSoup.
 
Ja, REST APIs laufen über HTTP. Tatsächlich gibts von Google auch eine Java Library, die das bereits übernimmt.
Ich würde gerne in einem gewöhnten Umfeld bleiben also Java nur finde ich keine Library die mir eine solche Suche ermöglichen würde. Zur Not müsste ich das eben von Hand bauen 🙃

So heißt es also Danke.

Die Frage wäre auch, ob es um Wikipedia-Einträge geht. Die gibts auch strukturiert und man kann derlei Daten gezielt abgreifen.
Ja auch 🙂 Wäre super wenn du verraten würdest wie man das macht 🤩
 
Der Stackoverflow Artikel beinhaltet ja schon alles 😊

Doch es ergeben sich mir noch ein paar Fragen dazu. Also erst einmal scheint man mit dieser main Methode genau das machen zu können was ich möchte und zwar eine Google Suche.
Java:
public static void main(String[] args) throws Exception {
    String google = "http://ajax.googleapis.com/ajax/services/search/web?v=1.0&q=";
    String search = "stackoverflow";
    String charset = "UTF-8";
    
    URL url = new URL(google + URLEncoder.encode(search, charset));
    Reader reader = new InputStreamReader(url.openStream(), charset);
    GoogleResults results = new Gson().fromJson(reader, GoogleResults.class);
    
    // Show title and URL of 1st result.
    System.out.println(results.getResponseData().getResults().get(0).getTitle());
    System.out.println(results.getResponseData().getResults().get(0).getUrl());
}

Dort hätte ich gleich zwei Fragen:
  1. Der String google im Code woher kommt diese http Adresse?
  2. Das Gson Objekt kommt aus der github Quelle, dort wird leider nur Beschrieben wie man es bei Maven und Gradle einbindet. Ich nutze noch Eclipse gibt es eine Anleitung wie man solche Programme/Bibliotheken/Frmaeworks in sein Projekt aufnehmen kann unter Eclipse?
Als letztes scheint es so das wir nur noch diese Klasse benötigen:
Java:
public class GoogleResults {

    private ResponseData responseData;
    public ResponseData getResponseData() { return responseData; }
    public void setResponseData(ResponseData responseData) { this.responseData = responseData; }
    public String toString() { return "ResponseData[" + responseData + "]"; }

    static class ResponseData {
        private List<Result> results;
        public List<Result> getResults() { return results; }
        public void setResults(List<Result> results) { this.results = results; }
        public String toString() { return "Results[" + results + "]"; }
    }

    static class Result {
        private String url;
        private String title;
        public String getUrl() { return url; }
        public String getTitle() { return title; }
        public void setUrl(String url) { this.url = url; }
        public void setTitle(String title) { this.title = title; }
        public String toString() { return "Result[url:" + url +",title:" + title + "]"; }
    }

}

Das sollte dann so funktionieren oder irre ich mich? Falls Ja muss ich mir später anschauen was man dabei raus bekommt und ob man die Anker Elemente erkennt um diese zu Speichern 🙂

Wäre nett wenn ich noch eine Antwort bekomme 😇
 
Heute läuft das via https://developers.google.com/custom-search/v1/overview und dort findest Du auch die o. g. Java libraries.
Schlecht!

Gibt es eine Möglichkeit das irgendwie anders zu machen? Könnte man das ganze auch mit JavaScript erstellen? Dann erzeugt man z. B. JSON Dokumente und ließt diese dann ein? Nur wüsste ich leider nicht wie ich mit JavaScript über google suchen könnte :-(

@mihe7 oder gibt es noch eine ganz andere Möglichkeit? Jetzt weiß ich gerade nicht weiter 😵


Man könnte doch auch den Query nutzen:

Das ganze dann über java.net.URL und java.net.URLConnection abwickeln oder? Nur weiß ich nicht was ich dann zurück bekomme und ob ich damit auch weiter Surfen kann auf Wikipedia etc. 😀 Außerdem frage ich mich ob so etwas überhaupt "erlaubt" ist da diese Engines ja alle Geld kosten ab einem gewissen Traffic 😀 Ich verstehe ja auch wenn man dann 1000 Sachen sucht das zu lasten von google ist eben auch nicht ganz die Feine Art oder ?
 
Zuletzt bearbeitet:
Was ist schlecht? Die Lib? Du kannst das alles auch ohne die Google Library machen. Natürlich geht auch JavaScript. Das sind alles einfach HTTP-Aufrufe und als Antwort bekommst Du JSON Text (ggf. kann man auch XML anfordern, da müsste man einen Blick in die Doku werfen).

Was die API selbst betrifft: die kommt von Google, da kannst Du nix dran ändern. Auch via HTML dürfte das heute nicht mehr ohne weiteres machbar sein. Die Style-Klassen etc. sind kodiert und ob die Kodierung immer die gleiche ist und stabil bleibt...
 
Was ist schlecht?
Es gehen mit der API nur 100 suche am Tag Kostenfrei 😀 Das ist schlecht ^.^ (sry habs vergessen dazu zu schreiben)

Du hast oben ja auch das hier erwähnt https://jsoup.org/
Vielleicht sollte ich mir das genauer anschauen.

Am liebsten wäre es mir wohl wenn ich es selbst versuche zu mache. Nicht das man dann noch in eine Kostenfall rein rutscht 😀
Nur weiß ich leider nicht wie ich dabei vorgehen muss deswegen dachte ich ja auch an eine Libary.

Noch eine Frage was meinst du mit css sind kodiert?
 
Noch eine Frage was meinst du mit css sind kodiert?
Such mal was in Google, dann klickst Du mit der rechten Maustaste in das Knowledge Panel und rufst im Kontextmenü (je nach Browser) den Punkt "Untersuchen" oder "Inspect" auf. Da findest Du dann so lustige Dinge wie:

HTML:
<div class="I6TXqe"><div class="osrp-blk" id="_dGdNY_O4LvCpxc8Px_ui2Ao_92">

Nicht nur die CSS-Klassen sind Kauderwelsch, vermutlich genau aus dem Grund, dass man den Spaß nicht einfach auslesen kann sondern die API verwenden muss. Das müsstest Du Dir aber ansehen; es könnte z. B. sein, dass das bei jeder Abfrage oder in zwei Browsern/Rechnern/externen IP-Adressen etc. zu unterschiedlichen Werten führt

Wenn Du Dir den Code auf der Seite hier ansiehst, findest Du dagegen etwas wie
HTML:
<div class="message-inner">
So etwas lässt sich dann leicht finden.
 
Wenn es in erster Linie um Wikipedia geht, dann ist evtl. die API von Wikipedia ja auch ein guter Startpunkt. Das nur mal so in den Raum gestellt.
 
Wenn es in erster Linie um Wikipedia geht, dann ist evtl. die API von Wikipedia ja auch ein guter Startpunkt. Das nur mal so in den Raum gestellt.
Wikipedia hat eine API für java? Ich lerne ja heute richtig viel dazu 🙂

Bei jsoup scheint es wohl auch ein Problem zu geben nach 500 Suchen wird man wohl mehr oder weniger gefandet und gesperrt 😀

Nochmal zurück wenn ich es mit java.net.URL und java.net.URLConnection versuche das klappt dann wohl auch nicht 😀 kam jetzt ganz durcheinander
Was ich meine ist wie hier:

Nur weiß ich nicht wie dann das result ausschaut und ob man dann eben auch erkennen würde was ein Anker ist und was nicht etc. (noch nie damit gearbeitet).

Wenn alle Stricke reißen lass ich das mit dem Suchen erst einmal weg und würde nach dieser Wikipedia API schauen 🙂 Das würde sicherlich fürs erste reichen 🙂 Wenn es dann halbwegs läuft irgendwann 2060 dann kann man ja Geld in die Hand nehmen und es über eine Google Search Engine laufen lassen 😀 haha
 
Du musst Dich erstmal davon lösen, dass das irgendwas mit irgendeiner Programmiersprache zu tun hätte.

Google betreibt einen Webserver (gut, vielleicht auch ein paar mehr 🙂) und der nimmt HTTP-Anfragen entgegen und antwortet darauf. Womit Du diese Anfragen stellst, ist dem Webserver völlig egal.

Es spielt also keine Rolle, ob Du per java.net.URL, JSoup, JavaScript, Python oder sonstwie die Daten abrufst: es ist immer einer HTTP-Anfrage, die vom Google Server beantwortet wird und Google hat das natürlich die Hand drauf. Die Antworten können sich je nach URL unterscheiden: der normale Seitenaufruf führt zu einer Antwort in HTML, die vom Browser dargestellt wird, die Anfragen an die REST-Endpoints (also die URLs, die in der API-Dokumentation genannt sind), führen eben z. B. zu JSON als Antwort.
 
Ganz vergessen: jetzt hast Du also eine Antwort in einem bestimmten Format erhalten und die musst Du ja irgendwie verarbeiten. Da kommen dann so Dinge wie JSON-Libraries ins Spiel oder JSoup zum Verarbeiten von HTML-Seiten.
 
Es spielt also keine Rolle, ob Du per java.net.URL, JSoup, JavaScript, Python oder sonstwie die Daten abrufst: es ist immer einer HTTP-Anfrage, die vom Google Server beantwortet wird und Google hat das natürlich die Hand drauf. Die Antworten können sich je nach URL unterscheiden: der normale Seitenaufruf führt zu einer Antwort in HTML, die vom Browser dargestellt wird, die Anfragen an die REST-Endpoints (also die URLs, die in der API-Dokumentation genannt sind), führen eben z. B. zu JSON als Antwort.
Achso und daran erkennt google dann auch relativ leicht wer was mit der Suchmaschine treibt und kann eben dann die IPs oder ähnliches sperren ;-)

Danke
 
Meinst du diese hier?

Ich finde nur nicht so ganz was ich damit tun kann und wie 😀
____
Das ganze mit dem REST bzw. net.URL schaue ich mir dennoch an sobald ich Zeit dafür finde ;-) Wikipedia würde erst einmal vollkommen ausreichen für mein Versuch 🙂
 
Jup die Seite habe ich nun auch gefunden.
Nur bin ich zu doof zu verstehen was die von mir wollen!

Also mal wieder gegooglet und gefunden das hier:

Dann läuft das ganze in JS (keine Ahnung ob es so überhaupt läuft 😀)! Leider habe ich NULL Erfahrungen mit diesen ganzen API Dingen :-(
Kann es gerne mal mit JS versuchen doch das geht sicherlich auch in Java oder liege ich Falsch?

Schade das es dafür keine Tutorials gibt wie man so etwas einbindet und so etwas 😟

__________
Das sieht mir nach einem Java Tutorial dafür aus:

und ebenfalls hier noch die gwtwiki jar Datei:
 

Neue Themen


Zurück
Oben