Historisierung - Alter Wert, Neuer Wert... wie speichern?

internet

Top Contributor
Hallo,

ich möchte ich meiner Applikation eine Historisierung machen.

1. Objekt wird geändert
-> Wert in der Datenbank geändert

2. Historisierung speichern
-> Es wird genau dokumentiert, was geändert wurde. (Alter Wert vs. Neuer Wert)

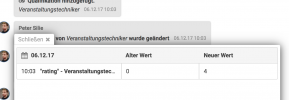
Bspw. wie hier:
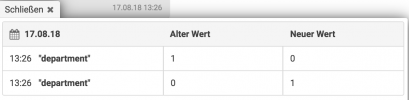
1646805852830.png

Ich speichere in der DB ja nicht mehrmals nun das Objekt, sondern der Wert wird ja überschrieben.

Wie macht man das in der Praxis?
- Hat man bpsw. eine History - Datenbank Tabelle:
-> Man erstellt vor dem Speichern ein JSON Objekt vom alten Wert des Objekts
-> Man erstellt nach dem Speichern ein JSON Objekt vom neuen Wert des Objekts

Oder wie macht man das?
 
Wir haben sowas in der Regel in der Datenbank gemacht mit Triggern, und der Trigger ist verantwortlich für die History Einträge.
 
danke für die Info....
Wenn ich es aber richtig lese, muss ich dann für jede einzelne Entität eine weitere Tabelle anlegen?

Nach diesem Schema ist nun für jede zu auditierende Tabelle eine Audittabelle anzulegen.
 
danke für die Info....
Wenn ich es aber richtig lese, muss ich dann für jede einzelne Entität eine weitere Tabelle anlegen?

Ja klar, da wirst du nicht drum rumkommen. Irgendwo müssen ja die historisierten Daten gespeichert werden
 
Dann hast aber unstrukturierte Daten, die sich sehr sehr schwer auswerten lassen. Weil du sie als Blob, String (Egal ob Json oder XML ablegen muss). Was wiederum heißt, du musst für jede Entity eine saubere String-Darstellung bauen. Wo ist das Problem bei 200 Tabellen? Das ist täglich Brot einer Datenbank Tabellen zu haben.
 
Alles andere würde nicht der 3. Normalform genügen.
Du müsstest alle Felder so oft duplizieren, wie du das Audit speichern willst.
Ob du 200 oder 400 Tabellen hast, dann ist das Dann auch nicht tragisch.
Du kannst ja schauen, ob es bestimmte Relationen gibt, die ein Audit benörigen und welche nicht.
 
Die Frage ist wirklich, was die genauen Anforderungen sind. Das hört sich jetzt mehr nach einem Logging an. Und entsprechend so kann man das dann auch bauen.

Aber das nur als Nennung einer weiteren Idee.
 
Du kannst grundsätzlich jeden Dateneintrag nicht als einzelnen Wert, sondern als History-Tabelle hinterlegen. Der aktuelle Wert ist dann immer der letzte.
Wenn du die Daten immer als Ganzes abspeicherst und nicht über einzelne Felder, kannst du auch einfach ein Image der gesamten Struktur sichern. Braucht zwar mehr Speicherplatz, ist aber die einfachste Lösung. Wenn du wissen willst, was geändert wurde, vergleichst du dann die gesamte Struktur.
 
Du kannst grundsätzlich jeden Dateneintrag nicht als einzelnen Wert, sondern als History-Tabelle hinterlegen. Der aktuelle Wert ist dann immer der letzte.
Wenn du die Daten immer als Ganzes abspeicherst und nicht über einzelne Felder, kannst du auch einfach ein Image der gesamten Struktur sichern. Braucht zwar mehr Speicherplatz, ist aber die einfachste Lösung. Wenn du wissen willst, was geändert wurde, vergleichst du dann die gesamte Struktur.
Naja, also eigentlich will ich nur dem User die Möglichkeit schaffen, dass er sieht, was sich geändert hat (siehe Scrennshot eingangs...). Also eigentlichen dann "Logging"...
Ich benötige nicht zwingend die Möglichkeit bpsw. das Objekt zurückzuholen, das vor 30 Tage gespeichert wurde bspw.

Daher war mein Ansatz eine Tabelle zu haben:
Tabelle "History", mit den Felder:
- String oldValue
- String newValue

-> In oldValue speichere ich dann das JSON Objekt zum damaligen Zeitpunkt
-> In newValue speichere ich dann das JSON Objekt zum jetzigen Zeitpunkt

-----
Wenn man sich dann in der GUI die Unterschiede ansehen möchte, dann gibt es eben noch eine Methode, die beide Objekte vergleicht und dann nur die Properties ausgibt, die sich unterscheiden...

Sowas hier:
1646818194695.png


1646818216793.png
 
Und wie ist das mit Objektbeziehungen? Also eine Klasse A, die eine Liste von Elementen der Klasse B hat.

Die Standard-JSON Darstellung wäre ja, dass die Elemente B als Sub-Elemente drin wären. Sprich du hättest das gesamte Objektgeflecht drin. Wenn sich nun einem Attribut in A was ändert, sollen dann in der Json-Darstellung alle Elemente von B drin sein?

Wie sieht es mit Hinzufügen/Löschen von Elementen aus? Wie soll das dargestellt werden?

Ich sehe da zwei grundsätzliche Ansätze:

a) Die Historisierung über Hibernate
Pro:
* Einfach umzusetzen
* Vollständig
Contra:
* Es wird alles historisiert

b) Die Historisierung selber bauen
Pro:
* Man kann genau das speichern, was sich geändert
Contra:
* Aufwendiger einzubauen


Ich würde bei b) anstelle auf Json zu gehen es auch lieber generischer machen, also eine Tabelle der Form

Spalten zur Objekt-Identifikation
Spalte Attribut-Name
Spalte Alter Wert
Spalte Neuer Wert

Dann musst du weniger speichern.
 
Wenn du eh mit Json arbeitest, kannst du ja anstatt 2 Feldern ein Objekt mit 2 Werten verwenden (aktueller Wert, letzter voriger Wert).
Ich hab das für mehrsprachige Bezeichnungen usw. gemacht. Anstatt in jedem Datenobjekt x Felder pro Sprache anzulegen, hab ich eine Klasse für mehrsprachige Texte angelegt, das dann an allen Stellen zum Einsatz kommt, wo mehrere Sprachen unterstützt werden sollen.

Die Daten auf eine Art rauszuziehen, wie du das im Screenshot machst, wird so aber ziemlich kompliziert.

Was du hier zeigst, ist eben genau ein Log.
D.h. dir reicht EINE Tabelle, in der du jede Aktion protokollieren musst. Wer, Wann, Was, Von, Nach.

Dafür musst du dann halt jedesmal, wenn irgendwo ein Wert geändert wird, einen Log-Eintrag schreiben.
 
prinzipiell baue ich das lieber selbst, damit ich mehr Flexibilität habe...
Die Frage ist gerade nur wie 🙂

Aktuell habe ich eine Tabelle, die zwar Aktivitäten (Tabelle History) loggt.
Aber nur was genau gemacht wurde (CRUD). Also ob etwas "erstellt", "geändert", "gelöscht" wurde...

Prinzipiell geht es nur um das Logging bei "Änderungen":
Nun möchte ich aber den nächsten Schritt gehen um zu sehen, WAS genau geändert wurde...
Prinzipiell soll es pro Änderung auch nur einen DB - Eintrag geben.
Also ich will nicht, dass ich bpsw. innerhalb einer Änderung - Operation insgesamt 5 Felder ändere und dann auch 5 DB - Einträge habe.... Daher meine Idee die Änderungen in einem String (XML / JSON) zu speichern, hier sehe ich aber mehr Probleme auf mich zu kommen (Datentypen etc.)

Ggf. wäre auch das möglich, sodass ich noch eine zweite Tabelle (HistoryValue) erstelle...

Tabelle History
- String type (mögliche Werte CREATE, MODIFY, DELETE)

Tabelle HistoryValue
- String entityType
- Long objectId
- String fieldName
- String valueOld
- String valueNew
- HistoryFK (Referenz auf History - Tabelle) -> Damit könnte man dann eben pro Operation alle Felder bekommen, die sich geändert haben...

Da meine Applikation auch Mehrsprachigkeit unterstützt, habe ich dann auch das Problem um herauszufinden, wie das entsprechende Feld in der unterschiedliche Sprache heißt...

Beispiel:
Ich ändere den Vornamen von: Markus zu Dieter...
Nun soll in der GUI eines deutschen User das Feld eben "Vorname" sein, bei einem englischsprachigen User "Surname"...

Hierfür wäre dann der Ansatz, den Feldname in der Tabelle zu speichern (String fieldName)...
Anhand einer Custom Annotation über jedem Feld bei der Entity, könnte ich das ja dann rausfinden.
Und dann eben dynamisch bei der entsprechenden Klasse (EntityType) das Feld heranzieht und dann die Annotation herausfindet, die mir den Feldnamen in der entsprechenden Sprache gibt.

Also sprich von der Sprache - Datei, wie man es bei der Bean Validation etc. macht:
Java:
@NotNull(message="{myBean.name.null.message}")

Beim Erstellen und Löschen reicht eigentlich nur:
a) Datensatz wurde erstellt
b) Datensatz wurde gelöscht
 
das meine ich doch...?

1. In der Tabelle "HistoryValue" speichere ich ja nur den Feldnamen.
2. Anhand Custom Annotations pro Feld, speichere ich Infos zu diesem Feld (Name etc.)
- Eine Information ist bpsw. "languageFeld="{myEntity.fieldName}"
- {myEntity.fieldName} führt zur Property Datei, in der dann der entsprechende Sprachtext steht
 
Die mehrsprachigen Label eines GUI in der DB abzulegen scheint mir doch recht umständlich. Die Label-Texte liegen normalerweise in Property-Dateien in der jeweiligen Sprache. Das nennt sich: Internationalizing - https://docs.oracle.com/javase/tutorial/i18n/intro/steps.html
Ich hab nicht von GUI-Labels gesprochen, sondern von Daten. Die UI kriegt die Texte über Properties, da sind wir einer Meinung
.
Es handelt sich in meinem Fall aber um durch den Benutzer erstellte Datensätze, die mehrsprachig benannt werden können müssen, z.B. ein Artikel oder Material, dessen Name und Kurzbeschreibung in mehreren Sprachen verfügbar sein soll (die anderen Eigenschaften sind natürlich sprachunabhängig). Dafür wäre eine properties-Datei ganz und gar nicht geeignet.
 
Zuletzt bearbeitet:
Sorry für die späte Antwort.
Nein, die Text für Artikel etc. speichere ich in einer weiteren Tabellen, die dann jeweils die Sprachtexte enthält (ähnlich, wie das zB in SAP geschieht).

Bzgl. dem Vergleich bei einem Objekt, was sich geändert hat.
Gibt es hierzu ein Framework, in dem ich von einer Klasse zwei Objekte in einer Methode gebe und ich dann nur die Attribute zurückbekomme, bei denen sich der Wert unterscheidet?
Klar, könnte ich das nun auch selbst bauen und mit zig "equals" - Abfragen das prüfen, aber vllt. kann man das auch einfacher lösen?

Ansonsten wäre mein Ansatz nun eher folgender:

Tabelle History
- String type (mögliche Werte CREATE, MODIFY, DELETE)
- String für XML / JSON

im Json / XML String, speichere ich dann diese Infos:

HistoryValue
- String entityType (Klassenname bzw. JPA Tabelle)
- Long objectId (ID in DB auf das Objekt)
- String fieldName (Feldname)
- String dataType (Datentyp)
- String valueOld (Wert alt)
- String valueNew (Wert neu)
 
Warum willst du in einer relationalen Datenbank JSON-Objekte (keine Arrays!) mit fester(!) Struktur speichern?

Und abgesehen davon: auf Dauer machst du es dir deutlich einfacher, pro Tabelle eine zusätzliche (gleich aufgebaute) Tabelle für Änderungen zu nutzen, anstatt das für alle Spalten aller Tabellen in einem Feld abzubilden.
 
Warum willst du in einer relationalen Datenbank JSON-Objekte (keine Arrays!) mit fester(!) Struktur speichern?
Andere Option wäre eben eine zweite Tabelle (siehe oben), die dann für jedes Feld die Änderung (alter Wert / neuer Wert) speichert. Also:

HistoryValue
- String entityType (Klassenname bzw. JPA Tabelle)
- Long objectId (ID in DB auf das Objekt)
- String fieldName (Feldname)
- String dataType (Datentyp)
- String valueOld (Wert alt)
- String valueNew (Wert neu)

Sehe aber nicht unbedingt einen Grund, was dagegen spricht es in JSON zu speichern und dann diesen JSON als String nur in der "History" - Tabelle zu speichern. Ich brauche ja ja nur die Info:

1. Entity wurde geändert.
2. Welche Informationen (Felder) wurden geändert.

Und abgesehen davon: auf Dauer machst du es dir deutlich einfacher, pro Tabelle eine zusätzliche (gleich aufgebaute) Tabelle für Änderungen zu nutzen, anstatt das für alle Spalten aller Tabellen in einem Feld abzubilden.
Das ist für mich keine Lösung bei über 300 Tabellen. Das ist der Aufwand einfach viel zu groß, für das was am Ende der Nutzen ist.
 
Das ist für mich keine Lösung bei über 300 Tabellen. Das ist der Aufwand einfach viel zu groß, für das was am Ende der Nutzen ist.
Wenn Du es mit Envers machst, dann werden die Tabellen doch auch automatisch angelegt - so habe ich das zumindest verstanden. Daher ist der Aufwand deutlich geringer.

Und der Aufwand verringert sich noch beim Zugriff, denn du kannst übder die angebotene API in Java problemlos auf die Daten zugreifen.

Wenn Du alles drekt in Java ("Code first") machst und die Dtaenbank generiert wird und so, dann ist die Idee aus #4 mit die beste Lösung mit minimalem Aufwand.

Wenn Du die Datenbank selbst verwaltest (Das hatte ich in Projekten in der Vergangenheit), dann wird das alles manuell gemacht, aber da täuscht die Arbeit. Die notwendigen Tabellen (Und bei uns auch Trigger, da das Auditing von der Datenbank gemacht wurde) konnten aus den vorhandenen Tabellen generiert werden. Das ist ein klares Schema F das anzuwenden ist. (Die Generierung bietet auch den Vorteil, dass Du die Methodik einmal getestest hast und Du dann eben nicht 300 Implementationen hast, die Du irgendwie testen musst um ggf. Fehler zu identifizieren wie ein Feld vergessen oder so ...)
 
Was soll den genau der Nutzen sein? Sorry, falls diese Frage bereits oben irgendwo beantwortet wurde.

Im einfachsten Fall, kannst du ja einfach eine Art von Log schreiben: "Benutzer xy hat das Feld z von a nach b geändert."

Ansonsten werfe ich jetzt einfach mal den Begriff Event Sourcing in den Raum. Wobei das wohl etwas zu hoch gegriffen ist.
Nachvollziehbarkeit...

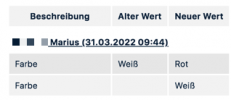
In diesem Screenshot sieht man es eig. ganz deutlich.
Es soll nachvollziehbar sein:
- Welcher User
- Welche Änderung wann gemacht hat

1648712812901.png

"Farbe" ist diesem Fall das Feld einer Klasse.
Nebendran dann eben "Alter Wert", "Neuer Wert"
 
Andere Option wäre eben eine zweite Tabelle (siehe oben), die dann für jedes Feld die Änderung (alter Wert / neuer Wert) speichert. Also:

HistoryValue
- String entityType (Klassenname bzw. JPA Tabelle)
- Long objectId (ID in DB auf das Objekt)
- String fieldName (Feldname)
- String dataType (Datentyp)
- String valueOld (Wert alt)
- String valueNew (Wert neu)

Sehe aber nicht unbedingt einen Grund, was dagegen spricht es in JSON zu speichern und dann diesen JSON als String nur in der "History" - Tabelle zu speichern. Ich brauche ja ja nur die Info:
Es gibt da ein ganz interessantes Konzept in relationalen Datenbanken: Spalten.
 
Nachvollziehbarkeit
Schon klar. Nachvollziehen kannst du es auch, wenn du in ein Log schreibst, wer, was, wann gemacht hat. Nur das Finden dieser Information ist dann etwas schwieriger.

Aber genau das ist der Punkt. Wie oft benötigst du genau diese Information?

Nur falls irgendwann, vielleicht eine Unregelmäßigkeit aufgetreten ist und man analysieren möchte, was passiert ist oder wer es gewesen ist?
Oder immer, wenn z. B. auf ein Datenfeld geklickt wird, um sofort die vollständige Änderungshistorie anzuzeigen?

Das sind unterschiedliche Qualitäten, die einen unterschiedlichen Aufwand benötigen. Letztlich sollte man nicht mehr Aufwand hineinstecken, als den, der notwendig ist, um das gewünschte Ziel zu erreichen.
 
Ich bin immer noch der Meinung, dass ein stinknormales Log hier reichen würde, es ist schließlich nicht Absicht, dass vorherige Zustände wiederhergestellt werden. Für die gewünschte Auswertung (siehe Post #12) muss nur protokolliert werden, wer wann was wovon wonach geändert hat.
Meldungen filtern dürfte nun wirklich kein Problem darstellen.
 
Es gibt da ein ganz interessantes Konzept in relationalen Datenbanken: Spalten.
Verstehe ich nicht, wie bei dir dann das Datenmodell aussehen würde. Wenn man später ggf. wirklich auswerten möchte, welches Feld wie oft geändert wurde, gebe ich dir Recht, dass eine SQL Tabelle die bessere Wahl ist. Meine gedachtes Datenmodell habe ich oben bereits gepostet.

Schon klar. Nachvollziehen kannst du es auch, wenn du in ein Log schreibst, wer, was, wann gemacht hat. Nur das Finden dieser Information ist dann etwas schwieriger.

Aber genau das ist der Punkt. Wie oft benötigst du genau diese Information?

Nur falls irgendwann, vielleicht eine Unregelmäßigkeit aufgetreten ist und man analysieren möchte, was passiert ist oder wer es gewesen ist?
Oder immer, wenn z. B. auf ein Datenfeld geklickt wird, um sofort die vollständige Änderungshistorie anzuzeigen?

Das sind unterschiedliche Qualitäten, die einen unterschiedlichen Aufwand benötigen. Letztlich sollte man nicht mehr Aufwand hineinstecken, als den, der notwendig ist, um das gewünschte Ziel zu erreichen.
Ich möchte nicht nachvollziehen, wann ein User einen Button gedrückt hat.
Ich möchte nachvollziehen, wenn ein User eine Entität gespeichert, geändert und ggf. gelöscht hat.
Es soll also wie ein Protokoll sein für die Nachvollziehbarkeit.

Ich bin immer noch der Meinung, dass ein stinknormales Log hier reichen würde, es ist schließlich nicht Absicht, dass vorherige Zustände wiederhergestellt werden. Für die gewünschte Auswertung (siehe Post #12) muss nur protokolliert werden, wer wann was wovon wonach geändert hat.
Meldungen filtern dürfte nun wirklich kein Problem darstellen.
Wie sieht bei dir ein "stinknormales Log" aus? In der Textdatei?
-> Falls in SQL, wie sieht hier das Datenmodell aus?

Mit dem von mir geposteten Datenmodell oben, könnte man bspw. mit Reflection die entsprechenden Felder wieder füllen und somit ebenfalls den Zustand wieder herholen.

Man hat im Zugriff:
- Klassenname
- Feldname
- Alter Wert / Neuer Wert

Anschließend schreibt man eben eine Methode, die mir die Klasse holt, das Feld und schreibt dann den alten Wert wieder mittels der SET - Methode rein. Habe es nicht getestet, aber sollte so gehen.

Das Prozedere sähe dann so aus:
1) Erstelle einen neuen Eintrag in Tabelle "History"
- Datum
- UserFK
- CRUD Type (zB als Enum)

2) Rufe Methode auf und vergleiche die zwei Objekte.
Speichere in der Tabelle "HistoryValue" nur die Einträge, bei denen die zwei Objekte sich unterscheiden.

Die eigentliche Frage ist nun allerdings noch, wie ich zwischen zwei Objekte von einer Klasse, nur die Unterschiede bzw. die Felder bekomme, die einen Unterschied im Wert aufweisen (ohne dafür jedes einzelne Feld via "equals" zu prüfen.

Wäre das nicht ggf. auch durch Reflection notwendig?
 
Dein geplantes Schema ist:
type
entityTypeobjectIdfieldNamedataTypevalueOldvalueNew
Also eine Spalte, in der 6 andere Spalten abgebildet sind, verpackt in JSON oder XML.

einfacher wäre einfach ein:
typeentityTypeobjectIdfieldNamedataTypevalueOldvalueNew
 
Ich möchte nicht nachvollziehen, wann ein User einen Button gedrückt hat.
Ich möchte nachvollziehen, wenn ein User eine Entität gespeichert, geändert und ggf. gelöscht hat.
Es soll also wie ein Protokoll sein für die Nachvollziehbarkeit.
Das hatte ich schon verstanden. Aber letztlich geht es darum, wie oft du diese Funktionalität in welcher Tiefe benötigen wirst.
Wenn man später ggf. wirklich auswerten möchte, welches Feld wie oft geändert wurde
Genau dieses. Die Möglichkeit dafür kann man sicher schaffen, aber wird man das jemals benötigen?

Du solltest nur soviel Aufwand in die Sache stecken, wie notwendig ist, um dein Ziel zu erreichen. Dazu musst du dein Ziel kennen und es sollte nicht nur "Nachvollziehbarkeit" lauten. Nachvollziehen kannst du Änderungen auch, wenn du tatsächlich einfach Logging in ein Textfile machst. Dann ist der Aufwand, etwas "nachzuvollziehen" halt etwas höher, aber wenn es eh nur selten oder evtl. gar nicht benötigt wird, reicht das aus.

Auf der anderen Seite, ist es z. B. für ein Dokumenten-Management-System schon sinnvoll mehr Aufwand hinein zu stecken, weil hier auch User diese Informationen vielleicht öfter benötigen.

Ich kenne dein System nicht, weiß also nicht, wie relevant diese Informationen im täglichen Gebrauch sind. Aber nur "weil das vielleicht mal jemand machen möchte" würde ich keinen gesteigerten Aufwand betreiben.
 
Dein geplantes Schema ist:
type
entityTypeobjectIdfieldNamedataTypevalueOldvalueNew
Also eine Spalte, in der 6 andere Spalten abgebildet sind, verpackt in JSON oder XML.

einfacher wäre einfach ein:
typeentityTypeobjectIdfieldNamedataTypevalueOldvalueNew
danke... glaube dann haben wir uns etwas falsch verstanden.
Wenn ich eine weitere Tabelle anlege (HistoryValue), hätte die auch so ausgesehen, nur dass ich
type, entityType, objectId herauslassen würde, da ich diese in der "Kopf Tabelle (=History)" bereits habe.
Zusätzlich käme dann eben ein FK in die Tabelle mit rein ("historyFk").

Dann hat eben eine Änderung 1....n geänderte Felder

Das hatte ich schon verstanden. Aber letztlich geht es darum, wie oft du diese Funktionalität in welcher Tiefe benötigen wirst.

Genau dieses. Die Möglichkeit dafür kann man sicher schaffen, aber wird man das jemals benötigen?

Du solltest nur soviel Aufwand in die Sache stecken, wie notwendig ist, um dein Ziel zu erreichen. Dazu musst du dein Ziel kennen und es sollte nicht nur "Nachvollziehbarkeit" lauten. Nachvollziehen kannst du Änderungen auch, wenn du tatsächlich einfach Logging in ein Textfile machst. Dann ist der Aufwand, etwas "nachzuvollziehen" halt etwas höher, aber wenn es eh nur selten oder evtl. gar nicht benötigt wird, reicht das aus.

Auf der anderen Seite, ist es z. B. für ein Dokumenten-Management-System schon sinnvoll mehr Aufwand hinein zu stecken, weil hier auch User diese Informationen vielleicht öfter benötigen.

Ich kenne dein System nicht, weiß also nicht, wie relevant diese Informationen im täglichen Gebrauch sind. Aber nur "weil das vielleicht mal jemand machen möchte" würde ich keinen gesteigerten Aufwand betreiben.
Ich denke anhand dem geposteten Screenshot sollte es klar sein, was ich gerne habe.

Offene Frage ist eben noch, wie ich die Unterschiede der zwei Objekte identifiziere?
 
Offene Frage ist eben noch, wie ich die Unterschiede der zwei Objekte identifiziere?
Das ist nicht trivial. Das musst du im Prinzip für jedes Attribut prüfen und ggf. anpassen.

Wir haben das bei uns im Modelling-Framework über einen Visitor-Pattern gelöst. Der bekommt zwei Objekte A und B reingegeben und besucht alle Attribute. Zusätzlich gibt es eine Konfiguration, die entscheidet, ob zwei Objekte gleich sind bzw. ob zwei Attribute gleich sind. Standardmäßig wird das über == und equals geprüft, aber das funktioniert nicht für alles. Insbesondere bei Listen hat man ein Problem, wenn die Reihenfolge unterschiedlich ist und Elemente hinzugefügt wurden oder entfernt wurden. Weil spätestens da kommt man rein mit Technik nicht mehr weiter, sondern muss fachlich entscheiden wann zwei Objekte das gleiche Business-Objekt referenzieren.
 
na, das Objekt, das den alten Wert enthält und das Objekt, was die neuen Änderungen enthält...
Kannst du nicht das "History"-Objekt direkt erstellen, wenn der Benutzer einen Wert ändert? Es gibt ja für jeden Wert ein separates History-Objekt, dass dann in die DB geschrieben wird.

Also in der Art: Ein Feld enthält einen Wert. Benutzer ändert den Wert. Du erzeugst ein Änderungsobjekt mit altem und neuen Wert. Sobald der geänderte Wert in die DB übertragen wird, schreibst du auch die Änderungsobjekte in die DB.
 
Zuletzt bearbeitet:
Eine Möglichkeit kann sein, dass man Änderungen erfasst, wenn diese durchgeführt wurden. Man hat ja ein Interface nach außen und wenn man Änderungen durchführt, dann merkt man sich dies. Beim Speichern muss man dann nur die erfassten Änderungen mit abspeichern und dann "löschen".

Man könnte also eine Klasse Change oder so erstellen, welche die Daten enthält wie Tabelle, Spalte, alter Wert, neuer Wert. In der Entity hat an dann eine List<Change> und in z.B. einem Setter wird dann eine neue Change Instanz erzeugt mit Klasse, Attribut, alter Wert und neuer Wert und der Liste hinzu gefügt.
 
Eine Möglichkeit kann sein, dass man Änderungen erfasst, wenn diese durchgeführt wurden. Man hat ja ein Interface nach außen und wenn man Änderungen durchführt, dann merkt man sich dies. Beim Speichern muss man dann nur die erfassten Änderungen mit abspeichern und dann "löschen".

Man könnte also eine Klasse Change oder so erstellen, welche die Daten enthält wie Tabelle, Spalte, alter Wert, neuer Wert. In der Entity hat an dann eine List<Change> und in z.B. einem Setter wird dann eine neue Change Instanz erzeugt mit Klasse, Attribut, alter Wert und neuer Wert und der Liste hinzu gefügt.
Irgendwie höre ich hier ein Echo 😉
 
Kannst nicht das "History"-Objekt direkt erstellen, wenn der Benutzer einen Wert ändert? Es gibt ja für jeden Wert ein separates History-Objekt, dass dann in die DB geschrieben wird.

Also in der Art: Ein Feld enthält einen Wert. Benutzer ändert den Wert. Du erzeugst ein Änderungsobjekt mit altem und neuen Wert. Sobald der geänderte Wert in die DB übertragen wird, schreibst du auch die Änderungsobjekte in die DB.
Doch. Das "History" - Objekt wird dann erstellt, wenn auch die Änderung durchgeführt wird.
Also sowas wie das stelle ich mir vor, wobei hier eben die Implementierung des Vergleichs fehlt und damit eine Liste<Changes> füllt.
Kann hier noch jemand helfen?

Java:
public void update(MyClass myobject){
   
    // lade derzeitiges Objekt aus der DB
    MyClass myobjectOld = loadById(myobject.getId());
   
    // Update in DB
    entityManager.merge(myobject);
   
    // Rufe Methode auf,
    saveChanges(myobjectOld, myobject)
}

public void saveChanges(Object myobjectOld, Object myobject){
   
    History history = new History();
    // Benutzer speichern, Erstellungsdatum etc. dem Objekt (lasse ich hier aber weg)
   
    entityManager.persist(history);
   
    // Erstelle HistoryValue
    checkDifferences(Object myobjectOld, Object myobject);
}

public void checkDifferences(Object myobjectOld, Object myobject){

    // Methode aufrufen, die noch fehlt
    List<Changes> list =  .......
       
    for(Changes changes : list){
        HistoryValue historyValue = new HistoryValue();
       
        // Set old Value, new Value aus dem Objekt "Changes"

        entityManager.persist(historyValue);
    }  
   
}
 
Also sowas wie das stelle ich mir vor, wobei hier eben die Implementierung des Vergleichs fehlt
Du musst die Änderung erfassen, wenn sie der Benutzer durchführt, also quasi, sobald er die Enter-Taste im Eingabefeld drückt. Direkt auf der Ebene des einzelnen Feldes, nicht auf der Ebene des kompletten "Datenobjektes", wie von dir gezeigt.

Es wäre sogar möglich durch den Benutzer ausschließlich diese Änderungsobjekte erzeugen zu lassen und dann aus der Liste der Änderungen einen neuen Datensatz zu generieren (das Datenobjekt), der dann komplett in die DB geschrieben wird.

Dann wird deine Methode zu update(List<ChangeObject> changes)
 
Du musst die Änderung erfassen, wenn sie der Benutzer durchführt, also quasi, sobald er die Enter-Taste im Eingabefeld drückt. Direkt auf der Ebene des einzelnen Feldes, nicht auf der Ebene des kompletten "Datenobjektes", wie von dir gezeigt.

Es wäre sogar möglich durch den Benutzer ausschließlich diese Änderungsobjekte erzeugen zu lassen und dann aus der Liste der Änderungen einen neuen Datensatz zu generieren (das Datenobjekt), der dann komplett in die DB geschrieben wird.

Dann wird deine Methode zu update(List<ChangeObject> changes)
ok, wäre auch ein Ansatz... aber dann reden wir auch wieder von einem ganz anderen Aufwand.

Denn dafür müsste ich dann in der GUI bei jeder Änderung (Feld, Selection Liste etc) eine Methode aufrufen, die mir die Änderung in einer Liste speichert und beim tatsächlichen Speichern zusätzlich mitgibt....
Mir würde der Vergleich der zwei Objekte reichen
 
danke... glaube dann haben wir uns etwas falsch verstanden.
Wenn ich eine weitere Tabelle anlege (HistoryValue), hätte die auch so ausgesehen, nur dass ich
type, entityType, objectId herauslassen würde, da ich diese in der "Kopf Tabelle (=History)" bereits habe.
Zusätzlich käme dann eben ein FK in die Tabelle mit rein ("historyFk").

Dann hat eben eine Änderung 1....n geänderte Felder
Wie sähe denn dein geplantes Model aus, wenn du JSON/XML nutzt?
ich glaube alle haben es aktuell so verstanden, dass du in einem Datenbank-Feld ein einzelnes Objekt mit mehreren Felder speichern willst - und das ganze stumpf normalisiert ist das, was ich gezeigt hab.
 
Wie sieht bei dir ein "stinknormales Log" aus? In der Textdatei?

Man hat im Zugriff:
- Klassenname
- Feldname
- Alter Wert / Neuer Wert

Anschließend schreibt man eben eine Methode, die mir die Klasse holt, das Feld und schreibt dann den alten Wert wieder mittels der SET - Methode rein. Habe es nicht getestet, aber sollte so gehen.
Ja, Textdatei. formatierte Texte, bzw. JSON Einträge sind ja kein Problem.
Aber wenn du's lieber in die DB schreibst, auch gut. Eine einfache Tabelle reicht.

Zeitpunkt, User, Tabelle, Spaltenname, alter Wert, neuer Wert und was auch immer dir sonst noch an interessanten Informationen einfällt.
Da man die Zugriffe auf die DB eh alle zentralisiert macht, wird das Log genau dort geschrieben.
Sobald ein Update an einer Tabelle kommt, wird erst mal der alte Datensatz eingelesen, dann das Update geschrieben, dann kommt ins Log, welche Felder geändet wurden.
 
Wie sähe denn dein geplantes Model aus, wenn du JSON/XML nutzt?
ich glaube alle haben es aktuell so verstanden, dass du in einem Datenbank-Feld ein einzelnes Objekt mit mehreren Felder speichern willst - und das ganze stumpf normalisiert ist das, was ich gezeigt hab.
Tabelle History
- String type (mögliche Werte CREATE, MODIFY, DELETE)
- String für XML

XML Objekt: "HistoryValue"
- String entityType (Klassenname bzw. JPA Tabelle)
- Long objectId (ID in DB auf das Objekt)
- String fieldName (Feldname)
- String dataType (Datentyp)
- String valueOld (Wert alt)
- String valueNew (Wert neu)

Im XML String stecken dann eben 1...n HistoryValue - Objekte
Vorteil
- wäre, ich benötige keine zweite SQL Tabelle.

Nachteil
- Auswertungen auf welcher Felder sich geändert haben, wäre durch XML schwerer, da man hier immer erst das XML einlesen muss.
-> Ich tendiere daher eher es in eine SQL Tabelle zu schreiben

Folgende Probleme sehe ich noch:
1) Wie oben schon erwähnt: Methode um zwischen zwei Objekte die Unterschiede zu identifizieren
2) Bei Datentypen wie int, long, double, String sehe ich kein Problem.. Wie sieht es aber bei Referenzen aus auf andere Objekte? Wie speichere ich diese ab?
 

Neue Themen


Zurück
Oben