Sicherheitslücke in Log4j

Ist das üblich, Benutzereingaben durch den Logger zu hauen?
Ja. Jeder 404 Error, der geloggt wird, hat Benutzereingaben - die URL. (Was das Hautp-Angriffszenario vermutlich ist)

Und wieso interpretiert Log4j einen String als Anweisung oder sonstwas?
Das ist die spannende Frage, da scheint einiges zusammen zu kommen. Grundsätzlich bieten Logging Frameworks oft String Formatierungen an, um String sauber zusammen zu bauen. Hier scheint es so zu sein, was ich aus dem Artikel entnehme, das einfach zu mächtige Tools/Frameworks dahinter stehen und die Kombination niemand gesehen hat. Oftmals (was im Server-Umfeld auch sinnvoll ist) sind solche Ersetzungsmechanismen mächtiger als reine String Lookups, so können je nach Typ der zu ersetzenden Variable Logik ausführen, um "Remote-Lookups" zu machen. Und genau das scheint hier zu passieren - es wird ein LDAP-Server kontaktiert und das Ergebnis wiederum ausgeführt.
 
Normalerweise sollte es kein Problem sein oder ist es bei euch üblich, dass ein Server wild irgendwelche URL's im Internet ansurft, noch dazu per JNDI-Lookup? Bei uns zumindest ist jeder Kontakt eines Servers in die Außenwelt verboten - nicht Anfragen von außen. Außer es wurden irgendwelche genaue Firewall-/Proxy-Regeln dafür erstellt, also IP/Port/Protokoll/Anfragemethode. Ich werde morgen trotzdem überall "log4j2.formatMsgNoLookups=true" setzen lassen und ein bisschen anschauen wie das CERT eskaliert.
 
Bei uns zumindest ist jeder Kontakt eines Servers in die Außenwelt verboten
Da ist dann aber wichtig: Das BSi hat die Schwachstelle hochgestuft, denn zum Ausnutzen ist dieser Kontakt nicht notwendig.

Maliziöser Code könne direkt in der Abfrage enthalten seien, sodass auch Grundschutz-konforme Systeme gefährdet seien, die keine Verbindung ins Internet aufbauen können. Als akute Maßnahmen empfiehlt das BSI, nicht zwingend benötigte Systeme abzuschalten, Netzwerke zu segmentieren, um verwundbare Systeme zu isolieren und soweit wie möglich etwa durch den Einsatz von Proxies in HTTP-Headern Inhalte durch statische Werte überschreiben zu lassen.
 
Ich hatte heute schon das erste Meeting zu log4j 🙂 Immerhin ist es bei uns im Projekt nur eine Dependency austauschen und wir sind (vermutlich) eh nicht betroffen, weil wir log4j nur an einer einzigen Stelle verwenden, wo keine User-Eingaben reinkommen. (+Die Server Admins haben die Workarounds bereits am Freitag aktiviert)
 
Da ist dann aber wichtig: Das BSi hat die Schwachstelle hochgestuft, denn zum Ausnutzen ist dieser Kontakt nicht notwendig.

Die Richtung Web -> Server ist wichtig, umgekehrt aber nicht. Also alles, was Benutzer-Request entgegennimmt und mit log4j loggt. Heise dramatisiert da etwas...

Sprich, solange euer Server keine Ports öffnet und auf Eingaben von außen lauscht, ist alles gut.
 
Die Richtung Web -> Server ist wichtig, umgekehrt aber nicht. Also alles, was Benutzer-Request entgegennimmt und mit log4j loggt. Heise dramatisiert da etwas...

Sprich, solange euer Server keine Ports öffnet und auf Eingaben von außen lauscht, ist alles gut.
Naja, aber eine Anwendung ohne Kommunikation ist in den seltensten Fällen sinnvoll.

Klar, wenn sie nicht direkt aus dem Internet sondern nur aus dem Intranet erreichbar ist, ist das Potential deutlich geringer - trotzdem ist sie verwundbar. Da reicht ein Firmen-Laptop der Malware hat und das Intranet scannt.

Zudem weiß in der Regel keiner genau, was exakt wirklich geloggt wird in allen Details. Das heißt, ein gefährlicher String kann über X Anwendungen wandern bevor er am Ende irgendwo mal einer verwundbaren Anwendung landet, sie von außen gar nicht erreichbar ist. Von daher ist das aus meiner Ansicht nach nicht dramatisiert - Der CVE Score ist ja auch 10/10, was nicht gerade oft vorkommt.
 
Die Richtung Web -> Server ist wichtig, umgekehrt aber nicht. Also alles, was Benutzer-Request entgegennimmt und mit log4j loggt. Heise dramatisiert da etwas...

Sprich, solange euer Server keine Ports öffnet und auf Eingaben von außen lauscht, ist alles gut.
Also ohne irgend jemandem zu nahe treten zu wollen:

Es spielt keine Rolle, von wo die Daten kommen, die geloggt werden, so lange Angreifer eine Möglichkeit finden, hier Daten vozugeben.

Klar: Firewalls und Co reduzieren die Angriffsfläche enorm. Ein Port, den nicht jeder erreichen kann, ist nicht so sehr gefährdet wie Ports, die aus dem Internet erreichbar sind. Aber dennoch bleibt die Angriffsmöglichkeit. Und wenn diese von jemandem kommt, der das Firmennetz schon infiltriert hat. (Dazu gehört oft nicht besonders viel... leider!)
 
Zudem weiß in der Regel keiner genau, was exakt wirklich geloggt wird in allen Details. Das heißt, ein gefährlicher String kann über X Anwendungen wandern bevor er am Ende irgendwo mal einer verwundbaren Anwendung landet, sie von außen gar nicht erreichbar ist.
Das ist ja das Geschiss. Irgendeine Lib reicht ggf. schon. Eine outbound Firewall sehe ich auch eher als last line of defense. Da ist es mir schon lieber, wenn ich das Problem an der Wurzel packen kann. Das ist zwar jetzt etwas Aufwand, danach habe ich aber meine Ruhe 🙂
 
Wobei der Aufwand sich im Rahmen hält - im Dependency Management in Maven die Version von log4j-core festschreiben auf 2.15.0, bauen, deployen, fertig. Je nach Anzahl Anwendungen und Vorgaben bzgl. Deployments nicht ganz unaufwändig, aber auch kein Riesen-Akt. Oder übersehe ich was?
 
Klar, wenn sie nicht direkt aus dem Internet sondern nur aus dem Intranet erreichbar ist, ist das Potential deutlich geringer - trotzdem ist sie verwundbar. Da reicht ein Firmen-Laptop der Malware hat und das Intranet scannt.
Ja von subversiven Elementen innerhalb des Firmennetzwerks bin ich jetzt mal nicht ausgegangen... Aber falls doch würde schon ein USB-Stick reichen. 😀
 
Ja von subversiven Elementen innerhalb des Firmennetzwerks bin ich jetzt mal nicht ausgegangen... Aber falls doch würde schon ein USB-Stick reichen. 😀
Das müssen nicht mal subversive Elemente sein. Der Punkt ist - die meisten Anwendungen verarbeiten Daten die die von außen (außen = Außerhalb der eigenen Anwendung) kommen. Ob die jetzt aus dem Internet, Intranet, User-Eingaben, maschinelle Verarbeitung von irgendwas etc. kommen - egal. Es sind Daten die von außerhalb der Anwendung kommen.

Kannst du die Hand dafür ins Feuer legen, dass bei der Erzeugung dieser Daten garantiert alles glatt läuft? Und diese Frage zieht sich Schritt für Schritt durch alle Anwendungen - und am Ende kommt man eigentlich immer bei Daten an, die wirklich von außen kommen, wo man keine Kontrolle mehr hat, wo die exakt erzeugt werden. Und da log4j eine deartig verbreitete Komponente ist, kann man nie ausschließen, dass auch der Zulieferer etc. nicht auch betroffen ist.
 
nein, übersiehst nichts, aber manchmal beinhaltet eine andere Lib (die zum Beispiel via Maven eingebunden wird) log4j, dann ist es glaube ich nicht ganz so einfach.

Edit: Es sind glaube auch nur "ältere" Java-Versionen betroffen...
Deswegen ja im eigenen Dependency Management die Version festlegen - damit überschreib ich die Version, die Libs mitbringen
 
Funktioniert natürlich nur, wenn nicht irgendso ein Uber-jar verwendet wurde. Dürfte bei uns aber nirgends der Fall sein.
 
Also nochmal zusammengefasst: Wenn in der Anwendung keine unkontrollierten Daten (die von außen stammen) geloggt werden, ist das völlig unbedenklich.
 
Was ein Sche**. Hab grad mal meine Spring Boot Anwendungen angeschaut, finde schon mal in den pom keine log4j dependencies und auch keine log4j.xml.

Wie kann ich denn möglichst einfach rausfinden ob andere Dependencies log4j nutzen?
 
Was ein Sche**. Hab grad mal meine Spring Boot Anwendungen angeschaut, finde schon mal in den pom keine log4j dependencies und auch keine log4j.xml.

Wie kann ich denn möglichst einfach rausfinden ob andere Dependencies log4j nutzen?
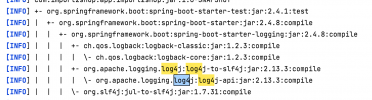
Dependency Hierachy - kann Maven von Haus aus und sollte jede IDE darstellen können. Wie es in Intellij geht - keine Ahnung, ich bin Eclipse Nutzer
 
Spring Boot Starter Test nutzt es wie es scheint.
1639419531340.png

Welche einfachste Möglichkeit hab ich jetzt? spring-boot-starter-test entfernen, ok. Könnte man die neue Version von log4j auch überschreiben in der pom?
 
Ich frage mich ja immer noch, wie es passieren kann, daß Benutzereingaben vom Rechner für ausführbaren Programcode gehalten werden können.

Wie würde ich das denn eigentlich machen, wenn ich das absichtlich machen wollte? Also einen String in Jave bekommen und den dann "ausführen"? Und würde das dann noch als Java-Bytecode ausgeführt, oder wäre das schon auf Maschinenebene?
 
Da ist keine Abhängigkeit dabei, die kritisch ist. log4j-core ist das problem, die nicht slf4j log4j Fassade

ahhhh ok puhh gott sei dank. Danke!

Am besten man nutzt wirklich so wenig wie möglich an externen Frameworks..
Ich frage mich ja immer noch, wie es passieren kann, daß Benutzereingaben vom Rechner für ausführbaren Programcode gehalten werden können.
Das frag ich mich auch...ist doch nur ne Log Ausgabe.
 
Ich frage mich ja immer noch, wie es passieren kann, daß Benutzereingaben vom Rechner für ausführbaren Programcode gehalten werden können.

Wie würde ich das denn eigentlich machen, wenn ich das absichtlich machen wollte? Also einen String in Jave bekommen und den dann "ausführen"? Und würde das dann noch als Java-Bytecode ausgeführt, oder wäre das schon auf Maschinenebene?
Du kommst runter bis zur Maschinenebene...

Und du siehst nur die Spitze des Eisbergs 😉
 
Ich frage mich ja immer noch, wie es passieren kann, daß Benutzereingaben vom Rechner für ausführbaren Programcode gehalten werden können.

Wie würde ich das denn eigentlich machen, wenn ich das absichtlich machen wollte? Also einen String in Jave bekommen und den dann "ausführen"? Und würde das dann noch als Java-Bytecode ausgeführt, oder wäre das schon auf Maschinenebene?
Kombination von - im Einzelnen gut klingenden - aber im Gesamtkontext katastrophalen Entscheidungen.

Punkt 1: Strings in Log Meldungen sollen nicht statisch sein, sondern aus Performance-Gründen String-Ersetzungen können.
Punkt 2: Log Meldungen sollen mit Patterns formatierbar sein - es soll ja nicht einfach der String geloggt werden, sondern auch Meta-Informationen (Datum, Thread-ID, Severity, etc.)
Punkt 3: Diese Meta-Informationen sollen möglichst flexibel sein und erweiterbar sein - hier kommt dann ein Plugin-Mechanismus ins Spiel der es erlaubt das man bei Ersetzungen dynamisch bestimmte Java-Klassen ausführt und das Ergebnis dann in den String packt

Wirft man das ganze zusammen, so bringt log4j einen Mechanismus mit:
* Meta-Informationen über einen JNDI-Lookup zu machen
* Diesen JNDI-Lookup an LDAP zu delegieren
* Darüber Java-Klassen (Den JNDI macht einen Lookup auf Java-Klassen) zu bekommen
* Diese Java-Klassen wiederum werden ausgeführt um den zu ersetzenden String zu bekommen

Hinzu kommt, dass das Pattern-Matching, das greift was geloggt werden soll nicht nur auf den in der log4j Config definierten String angewendet wird, sondern auf den zu loggenden String (Ob das bewusst ist oder nicht weiß ich nicht, ich würde das als Bug sehen)

Wirft man das ganze zusammen, passiert genau das, was jetzt passiert ist. Bzgl. der Lookups steht (vermutlich seit Freitag) folgendes der Doku (https://logging.apache.org/log4j/2.x/manual/lookups.html#JndiLookup):
When using LDAP Java classes that implement the Referenceable interface are not supported for security reasons. Only the Java primative classes are supported by default as well as any classes specified by the log4j2.allowedLdapClasses property
 
Verstehe ich das richtig, dieses Problem entsteht da, wo ein User etwas in ein Textfeld eingibt und diese Eingabe in das Logfile gelogged wird?
Warum logged man Usereingaben? Für Testzwecke ok. Aber mir fällt (in meiner Anwendung) kein sinnvoller Grund ein warum ich (uU sensible) Benutzereingaben loggen soll
Mir fällt kein Grund ein, warum Benutzerreingaben nicht in Logs auftauchen - eher im Gegenteil, die gehören in Logs.

404 Error => Im Log steht die URL die nicht erreichbar ist => URL = Benutzereingabe
NumberFormatException bzw. andere Exceptions bzgl. Stringhandling => Oft steht im Exception der String der nicht geparst wird => String = Benutzereingabe

Im Fehlerfall will man die Eingabe haben, die zum Fehler geführt. Und oft führen Daten von außen zum Fehler - dann will ich die im Log haben. Ich will den Fehler ja nachstellen können.
 
Im Fehlerfall will man die Eingabe haben, die zum Fehler geführt. Und oft führen Daten von außen zum Fehler - dann will ich die im Log haben. Ich will den Fehler ja nachstellen können.
Es geht weniger ums Speichern der Logs, sondern um das Auslesen. Wenn der Text beim Auslesen interpretiert wird, dann kann ein Fehler auftauchen. Da Interpretieren beim Auslesen aber eine gewünschte Funktion ist, muss man Text, der nicht interpretiert werden soll, als "pure text" kennzeichnen, bzw. verpacken.
 
Es geht weniger ums Speichern der Logs, sondern um das Auslesen. Wenn der Text beim Auslesen interpretiert wird, dann kann ein Fehler auftauchen. Da Interpretieren beim Auslesen aber eine gewünschte Funktion ist, muss man Text, der nicht interpretiert werden soll, als "pure text" kennzeichnen, bzw. verpacken.
Was log4j ab 2.16.0 auch genau standardmäßig macht, da wird der ganze Ersetzungsmechanismus nur auf das Pattern angewendet und nicht auf Text, der von "außen" kommt, also aus der Anwendung.

Also es gibt genug Daten, wo das problematisch ist. Passwörter z.B. Aber auch sensible personenbezogene Daten möchte man nicht im Log haben.
Klar, ich will natürlich nicht alles logen - aber an vielen Stellen hat man entweder explizit "Externe Daten" in der Log-Meldung (Beispiel 404 Error) oder Implizit - weil man im Falle eines Exception Logs wenig Kontrolle darüber hat, was genau in der Exception Message steckt, weil die ja oft aus einer tiefen Schicht kommt und nicht selbst erzeugt wird. Klassiker z.B. beim Versucht Werte die zu groß sind speichern, da kommt teilweise auch eine Meldung, dass der Wert zu groß ist und der Wert ist in der Meldung enthalten. Ich will nur drauf hinweisen, das externe Daten in Log-Meldungen enthalten sind, kommt sehr oft vor und ist oft auch erwünscht.
 
Klar, ich will natürlich nicht alles logen - aber an vielen Stellen hat man entweder explizit "Externe Daten" in der Log-Meldung (Beispiel 404 Error) oder Implizit - weil man im Falle eines Exception Logs wenig Kontrolle darüber hat, was genau in der Exception Message steckt, weil die ja oft aus einer tiefen Schicht kommt und nicht selbst erzeugt wird. Klassiker z.B. beim Versucht Werte die zu groß sind speichern, da kommt teilweise auch eine Meldung, dass der Wert zu groß ist und der Wert ist in der Meldung enthalten. Ich will nur drauf hinweisen, das externe Daten in Log-Meldungen enthalten sind, kommt sehr oft vor und ist oft auch erwünscht.
Ganz klar. Ich habe auch nur Beispiele für Eingaben genannt, die ich nicht logge. Dazu gehören die meisten Angaben aber nicht und da war ich auch voll und ganz Deiner Meinung - die landen im Logfile alleine schon um da Abläufe nachvollziehen zu können (Natürlich in Abhängigkeit zum Loglevel!)
 
Sowohl die JNDI-Möglichkeiten wie Lookup von Daten als auch Klassen von einem fremden Server herunterzuladen, sind keine Features von Log4J, sondern von Java selbst. In Log4J ist es nach 8 Jahren aufgefallen, dass so etwas möglich ist. Es ist denkbar, dass in anderen Programmen oder Bibliotheken ebenfalls Usereingaben so interpretiert werden, dass ein JNDI-Lookup ausgeführt wird.
 
Sowohl die JNDI-Möglichkeiten wie Lookup von Daten als auch Klassen von einem fremden Server herunterzuladen, sind keine Features von Log4J, sondern von Java selbst. In Log4J ist es nach 8 Jahren aufgefallen, dass so etwas möglich ist. Es ist denkbar, dass in anderen Programmen oder Bibliotheken ebenfalls Usereingaben so interpretiert werden, dass ein JNDI-Lookup ausgeführt wird.
Ehm - dem muss ich mal widersprechen. Ich muss schon aktiv einen JNDI Lookup anstoßen, automatisch passiert da mal gar nichts.

Wie soll das funktionieren? Nur weil magisch in einem String irgendwo was jndi drin steht, passiert da kein Lookup.
 
Ehm - dem muss ich mal widersprechen. Ich muss schon aktiv einen JNDI Lookup anstoßen, automatisch passiert da mal gar nichts.

Wie soll das funktionieren? Nur weil magisch in einem String irgendwo was jndi drin steht, passiert da kein Lookup.
Diese Hinweis entstammt sinngemäß aus einem Hinweis unserer Sicherheitsfirma, die mit unserem CERT zusammenarbeitet.
 

Neue Themen


Zurück
Oben